
시스템아 미안해
Chapter 7: Make it cheap - Item 47: Avoid unnecessary object creation 본문
Chapter 7: Make it cheap - Item 47: Avoid unnecessary object creation
if else 2026. 3. 9. 16:44오늘날 코드 효율성은 종종 관대하게 다뤄집니다. 어느 정도는 합리적인 접근입니다. 메모리는 저렴하고 개발자는 비싸기 때문입니다. 그러나 그렇다고 해서 효율성을 무시해서는 안 됩니다.
예를 들어 다음과 같은 상황을 생각해 볼 수 있습니다.
- 여러분의 애플리케이션이 수백만 개의 디바이스에서 실행된다면, 그만큼 많은 에너지를 소비하게 됩니다. 이때 배터리 사용을 조금만 최적화해도 작은 도시 하나를 운영할 만큼의 에너지를 절약할 수도 있습니다.
- 회사가 서버와 유지 비용에 많은 돈을 쓰고 있다면, 약간의 최적화만으로도 운영 비용을 크게 줄일 수 있습니다.
- 애플리케이션이 적은 요청에서는 잘 동작하지만, 갑작스러운 트래픽 증가 상황에서 확장성이 부족해 제대로 동작하지 않는 경우도 있습니다. 고객은 이런 상황을 오래 기억합니다.
따라서 장기적으로 효율성은 매우 중요합니다. 하지만 최적화는 쉬운 작업이 아닙니다. 특히 너무 이른 시점의 최적화(premature optimization) 는 오히려 더 많은 문제를 만들 수 있습니다.
대신 다음과 같은 접근이 더 바람직합니다.
적은 비용으로 성능을 개선할 수 있는 기본 규칙들을 먼저 적용하는 것입니다. 이런 방법들을 흔히 “cheap wins” 라고 부릅니다.
- 구현 비용은 거의 들지 않지만
- 성능 개선 효과는 꽤 큰 방법들입니다.
이러한 방법들로 충분하지 않을 때는 프로파일러(profiler) 를 사용해 성능에 중요한 부분(performance-critical parts) 을 찾아 최적화해야 합니다. 다만 이것은 더 어려운 작업입니다. 어떤 작업이 비용이 큰지, 어떤 방식으로 최적화할 수 있는지에 대해 더 깊은 이해가 필요하기 때문입니다.
이 책의 이번 장과 다음 장은 성능(performance) 에 대해 다룹니다.
- Chapter 7 — Make it cheap
성능을 개선하기 위한 일반적인 접근 방법 - Chapter 8 — Efficient collection processing
컬렉션 처리 성능 최적화에 집중
이 두 장에서는 일상적인 개발 과정에서 부담 없이 적용할 수 있는 일반적인 최적화 규칙을 설명합니다. 또한 프로그램의 성능이 중요한 부분에서 사용할 수 있는 Kotlin 특화 최적화 방법도 소개합니다.
이 내용들은 성능을 바라보는 관점 자체를 넓혀 주는 데에도 도움이 될 것입니다.
마지막으로 기억해야 할 점이 있습니다.
가독성과 성능 사이에 트레이드오프가 발생할 때, 여러분은 항상 어떤 것이 더 중요한지 스스로 판단해야 합니다.
몇 가지 권장 사항은 제시할 수 있지만, 모든 상황에 적용되는 정답은 존재하지 않습니다.
객체 생성에는 항상 비용이 따르며, 때로는 그 비용이 상당할 수 있습니다. 그래서 불필요한 객체 생성을 피하는 것이 중요한 최적화가 될 수 있습니다. 이는 여러 수준에서 적용됩니다. 예를 들어 JVM에서는 동일한 가상 머신에서 실행되는 코드가 같은 문자열 리터럴을 포함하면 해당 문자열 객체를 재사용하는 것이 보장됩니다.
val str1 = "Lorem ipsum dolor sit amet"
val str2 = "Lorem ipsum dolor sit amet"
print(str1 == str2)  // true
print(str1 === str2) // true
박싱된 기본 타입(Integer, Long)도 값이 작은 경우 JVM에서 재사용됩니다. 기본적으로 Integer 캐시는 -128에서 127 범위의 숫자를 보관합니다.
val i1: Int? = 1
val i2: Int? = 1
print(i1 == i2)  // true
print(i1 === i2) // true, because i2 was taken from cache
그러나 -128보다 작거나 127보다 큰 숫자를 사용하면 별도의 객체가 생성됩니다.
val j1: Int? = 1234
val j2: Int? = 1234
print(j1 == j2)  // true
print(j1 === j2) // false
nullable 타입을 사용하면 내부적으로 기본 타입 int 대신 Integer를 강제로 사용하게 됩니다. Int는 일반적으로 기본 타입 int로 컴파일되지만, nullable로 만들거나 타입 인자로 사용하면 박싱된 Integer가 사용됩니다. 기본 타입은 null이 될 수 없고 타입 인자로도 사용할 수 없기 때문입니다.
코틀린에 이런 메커니즘들이 있다는 것을 알게 되면, 이것들이 실제로 얼마나 중요한지 궁금해질 수 있습니다.
그리고 이런 질문이 자연스럽게 따라옵니다.
객체 생성은 비용이 큰 작업일까?
객체 생성은 비싼가?
어떤 값을 객체로 감싸면(wrapping) 다음과 같은 세 가지 비용이 발생합니다.
1. 객체는 추가적인 메모리 공간을 차지합니다.
현대의 64-bit JDK에서는 객체에 12바이트의 헤더(header) 가 존재하며, 이 값은 8바이트 배수로 패딩되기 때문에 최소 객체 크기는 16바이트입니다.
32-bit JVM에서는 오버헤드가 8바이트입니다.
또한 객체 참조(reference) 도 메모리를 차지합니다.
- 일반적으로 참조 크기
- 4바이트: 32-bit 환경 또는 64-bit 환경에서 -Xmx32G 이하
- 8바이트: 메모리 풀을 -Xmx32G 이상으로 설정한 경우
이 숫자들은 각각 보면 작지만, 많이 쌓이면 상당한 비용이 될 수 있습니다.
특히 정수 같은 작은 데이터에서는 차이가 더 커집니다.
- Int (primitive) → 4바이트
- Int를 객체로 래핑한 경우 (예: Integer)
- 객체 자체: 16바이트
- 참조: 4 또는 8바이트
결국 5~6배 정도 더 많은 메모리를 사용하게 됩니다.
그래서 primitive 배열(IntArray)은 래퍼 타입 배열(Array<Int>)보다 약 5배 적은 메모리를 사용합니다.
(참고: Item 58 — 성능이 중요한 처리에서는 primitive 배열을 고려하라)
2. 캡슐화된 요소에 접근할 때 추가적인 함수 호출이 발생합니다.
객체로 감싸진 값에 접근하려면 추가적인 메서드 호출이 필요합니다.
함수 호출 자체는 매우 빠르기 때문에 개별 비용은 작습니다.
하지만 수백만 개의 객체를 처리하는 상황에서는 이 비용이 누적될 수 있습니다.
이 비용을 줄이거나 제거하는 방법은 다음 항목에서 설명됩니다.
- Item 51 — 함수형 타입 파라미터를 가진 함수에는 inline 사용
- Item 49 — inline class 사용 고려
3. 객체 생성과 메모리 할당 비용이 발생합니다.
객체를 만들 때는 다음과 같은 작업이 필요합니다.
- 객체 생성
- 메모리 할당
- 참조(reference) 생성
각각의 비용은 작지만 객체 수가 많아지면 빠르게 누적됩니다.
예를 들어 다음 코드에서는 객체 생성 비용이 얼마나 발생하는지 확인할 수 있습니다.
class A

private val a = A()

// Benchmark result: 2.698 ns/op
fun accessA(blackhole: Blackhole) {
    blackhole.consume(a)
}

// Benchmark result: 3.814 ns/op
fun createA(blackhole: Blackhole) {
    blackhole.consume(A())
}

// Benchmark result: 3828.540 ns/op
fun createListAccessA(blackhole: Blackhole) {
    blackhole.consume(List(1000) { a })
}

// Benchmark result: 5322.857 ns/op
fun createListCreateA(blackhole: Blackhole) {
    blackhole.consume(List(1000) { A() })
}
객체를 아예 생성하지 않도록 설계하면, 앞에서 언급한 세 가지 비용을 모두 피할 수 있습니다.
또한 객체를 재사용(reuse) 하면 첫 번째와 세 번째 비용을 줄일 수 있습니다.
- 메모리 공간 사용
- 객체 생성 및 메모리 할당 비용
객체의 비용을 이해하게 되면, 불필요한 객체 생성을 줄이는 방향으로 애플리케이션을 설계할 수 있습니다.
즉, 불필요한 객체 수를 최소화하는 것이 성능 개선의 핵심 전략 중 하나입니다.
다음 몇 개의 항목에서는 객체를 제거하거나 줄이는 다양한 방법을 살펴보게 됩니다.
이 항목에서는 그중 하나만 소개합니다.
바로 래퍼 타입(wrapped types) 대신 primitive 타입을 사용하는 방식으로 클래스를 설계하는 것입니다.
기본 타입 사용하기
JVM에는 숫자나 문자와 같은 기본 데이터를 표현하기 위한 특별한 내장 타입이 있습니다. 이를 primitive 타입이라고 합니다. Kotlin/JVM 컴파일러는 가능한 경우 내부적으로 이러한 primitive 타입을 사용하도록 최적화합니다.
하지만 어떤 상황에서는 primitive 대신 래퍼 클래스(wrapped class) 를 사용해야 합니다.
래퍼 클래스는 primitive 값을 내부에 담고 있는 객체 인스턴스입니다.
대표적인 경우는 다음 두 가지입니다.
- nullable 타입을 사용할 때
primitive 타입은 null 값을 가질 수 없기 때문입니다. - 제네릭 타입 인자로 사용할 때
제네릭은 객체 타입만 사용할 수 있기 때문에, primitive 대신 래퍼 타입이 사용됩니다.
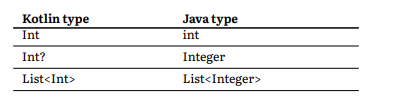
이제 여러분은 래퍼 타입 대신 primitive 타입이 사용되도록 코드를 최적화할 수 있다는 점을 알게 되었습니다.
이러한 최적화는 주로 Kotlin/JVM 환경이나 일부 Kotlin/Native 환경에서 의미가 있습니다. 반면 Kotlin/JS에서는 거의 의미가 없습니다.
primitive와 래퍼 타입에 대한 접근 속도 자체는 다른 연산에 비해 충분히 빠른 편입니다. 하지만 차이는 다음과 같은 상황에서 드러납니다.
- 큰 컬렉션을 다룰 때
(이 부분은 Item 58: Consider Arrays with primitives for performance-critical processing에서 더 자세히 설명됩니다.) - 특정 객체를 매우 집중적으로 사용하는 경우
또 하나 중요한 점은, 무리하게 primitive 기반으로 코드를 바꾸면 가독성이 떨어질 수 있다는 것입니다. 따라서 이러한 최적화는 다음과 같은 경우에만 적용하는 것이 좋습니다.
- 성능이 중요한 코드 영역
- 라이브러리 코드
그리고 어떤 부분이 실제로 성능에 중요한지 판단하려면 프로파일러(profiler) 를 사용해야 합니다.
이제 구체적인 예를 하나 생각해 보겠습니다.
여러분이 금융 애플리케이션을 개발하고 있고, 주식 스냅샷(stock snapshot) 을 표현해야 한다고 가정해 보겠습니다.
이 스냅샷은 초당 두 번 갱신되는 값들의 집합이며, 다음과 같은 정보를 포함합니다.
class Snapshot(
    var afterHours: SessionDetails,
    var preMarket: SessionDetails,
    var regularHours: SessionDetails,
)

data class SessionDetails(
    val open: Double? = null,
    val high: Double? = null,
    val low: Double? = null,
    val close: Double? = null,
    val volume: Long? = null,
    val dollarVolume: Double? = null,
    val trades: Int? = null,
    val last: Double? = null,
    val time: Int? = null,
)
주식 수만 개를 추적하고 있고, 각 주식의 스냅샷이 초당 두 번씩 갱신된다면, 애플리케이션은 매초 매우 많은 SessionDetails 인스턴스를 생성하게 됩니다. 그리고 이는 가비지 컬렉터에 큰 부담을 주게 됩니다.
이 문제를 줄이기 위해서는 nullable을 제거해서, SessionDetails 클래스가 래퍼 타입 대신 primitive 타입을 사용하도록 변경할 수 있습니다.
data class SessionDetails(
    val open: Double = Double.NaN,
    val high: Double = Double.NaN,
    val low: Double = Double.NaN,
    val close: Double = Double.NaN,
    val volume: Long = -1L,
    val dollarVolume: Double = Double.NaN,
    val trades: Int = -1,
    val last: Double = Double.NaN,
    val time: Int = -1,
)
이 변경은 가독성을 떨어뜨리고 클래스 사용도 더 어렵게 만든다는 점에 주의해야 합니다.
일반적으로 값이 없음을 표현할 때는 NaN이나 -1 같은 특수 값(sentinel value) 보다 **null을 사용하는 것이 더 명확하기 때문입니다.
하지만 이 경우에는 애플리케이션의 성능이 중요한 영역을 다루고 있기 때문에 이러한 변경을 선택했습니다.
null 가능성을 제거함으로써 객체 생성 수와 메모리 사용량을 크게 줄일 수 있습니다.
일반적인 환경에서 비교해 보면 다음과 같은 차이가 발생합니다.
- 첫 번째 SessionDetails 구현
- 메모리 할당: 192 bytes
- 생성 객체 수: 10개
- 두 번째 SessionDetails 구현
- 메모리 할당: 80 bytes
- 생성 객체 수: 1개
즉, 객체 수가 수만 개에 이르는 상황에서는 충분히 의미 있는 차이가 됩니다.
만약 이러한 최적화만으로도 부족하다면, 객체 풀(object pool) 이라는 매우 강력하지만 동시에 위험한 패턴을 고려할 수도 있습니다.
이 패턴의 핵심 아이디어는 다음과 같습니다.
- 객체를 mutable하게 만들고
- 사용이 끝난 객체를 보관했다가 재사용하는 것
하지만 이 패턴은 정확하게 구현하기가 어렵고, 특히 동기화 문제(synchronization issues) 를 일으키기 쉽습니다. 그래서 정말 필요한 상황이 아니라면 사용을 권장하지 않습니다.